第 23 課 - マインドマップ
多くの無限キャンバスアプリケーションがマインドマップをサポートしています。miro、excalidraw、canva、xmind などです。 私は excalidraw の分類の仕方が気に入っています。マインドマップを三つの下位タイプに分けています。
- Spider mapping はブレインストーミングに向いており、中心の核となるテーマからクモの巣のように広がります。レンダリングの観点では、mermaid もこのタイプを提供しています。
- Tree mapping
- Flow map
| スパイダーマッピング | ツリーマッピング | フローマップ |
|---|---|---|
 |  |  |
ここでは最後の種類だけを扱います。
マインドマップの最終的な見た目は大きく異なり得ますが、データ構造の観点では、ノードとエッジからなる木構造です。markmap と mermaid はマークダウンをこの構造へ変換します。木は特別なグラフ構造であり、dagre や elkjs のような有向グラフ向けのレイアウトアルゴリズムもありますが、ここでは扱いません。
{
    "id": "Modeling Methods",
    "children": [
        {
            "id": "Classification",
            "children": []
        }
    ]
}この種のデータに対して、d3-hierarchy はすぐに使えるアルゴリズムを一通り提供しており、私たちは d3-tree だけに注目します。
d3-tree
まず二つの制約を置きます。あとでどう破るかを紹介します。対象は二分木であり、すべてのノードは同じ大きさです(あるいは大きさを持ちません)。
d3-tree の実装の考え方は Tidier Drawings of Trees に由来します。この論文は先行研究を踏まえて、いくつかの美的基準を提案しています。
- 美的基準 1: 木の同じレベルにあるノードは 一直線上に並び、レベルを定める直線は 互いに平行であるべきです。
- 美的基準 2: 左の子は親の左に、 右の子は親の右に置かれるべきです。
- 美的基準 3: 親は子たちの中央の上に置かれるべきです。
- 美的基準 4: 木とその鏡像は、互いに鏡写しの図になるべきです。さらに、部分木は木のどこに現れても同じ描き方になるべきです。
最初の三つの基準がどう発展し改善されたかは Drawing Presentable Trees で読めます。この文章は Python のコードと図で、先行論文のアルゴリズム的な考え方を詳しく示しています。たとえば第三の基準の実装は単純です。後行順走査を使い、親ノードの x 座標を、最も左の子と最も右の子の中点に設定します。
// @see https://github.com/d3/d3-hierarchy/blob/main/src/tree.js#L150
var midpoint = (children[0].z + children[children.length - 1].z) / 2;
まだ十分に対称ではなく、全体として右に偏っていることがはっきり分かります。これが第四の基準へつながります。
| 可能な限り狭く | 親は子たちの中央の上にあるべきです |
|---|---|
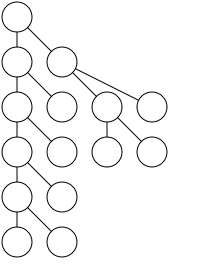 | 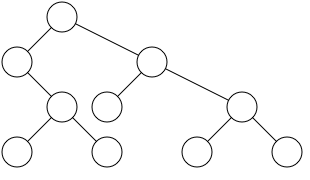 |
親ノードを中央に揃える操作は、兄弟ノードの位置と衝突することがあります。このとき部分木全体を動かす必要がありますが、次のような再帰的な方法を使うと、アルゴリズムの計算量は
def move_right(branch, n):
    branch.x += n
    for c in branch.children:
        move_right(c, n)
このときノードに mod 属性を追加すると、親を中央に揃える操作は衝突をいったん無視し、移動を後回しにできます。これで再帰を避け、アルゴリズムの計算量は再び prelim 属性も追加する必要があり、その名前は A Node-Positioning Algorithm for General Trees に由来します。
// @see https://github.com/d3/d3-hierarchy/blob/main/src/tree.js#L67
function TreeNode(node, i) {
    this._ = node; // final position: _.x
    this.parent = null;
    this.children = null;
    this.z = 0; // prelim
    this.m = 0; // mod
}
後行順走査を使っているためです。
function tree(root) {
    var t = treeRoot(root);
    t.eachAfter(firstWalk);
    t.eachBefore(secondWalk);
}
2 回目の先行順走査で mod を再帰的に累積し、右方向への移動を完了して最終位置 _.x を得ます。これは原論文の PETRIFY 手順に対応します。
// @see https://github.com/d3/d3-hierarchy/blob/main/src/tree.js#L164
function secondWalk(v) {
    v._.x = v.z + v.parent.m; // final x
    v.m += v.parent.m;
}
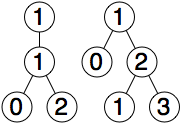
ここで contour の概念を導入します。たとえば下の左の木の右輪郭は [1, 1, 2]、右の木の左輪郭は [1, 0, 1] です。この二つの部分木が重ならないようにするには、二つの輪郭を比較するだけで、右の木を右へどれだけ動かせばよいか決まります。この例では移動距離は 2 です。
def push_right(left, right):
    wl = contour(left, lt)
    wr = contour(right, gt)
    return max(x-y for x,y in zip(wl, wr)) + 1
部分木の輪郭を得るアルゴリズムは依然として再帰が必要なので、計算量は thread の概念を導入します。下図の破線は親子とは異なるこの関係を表し、実際には存在しないかもしれない各部分木の輪郭を描きます。
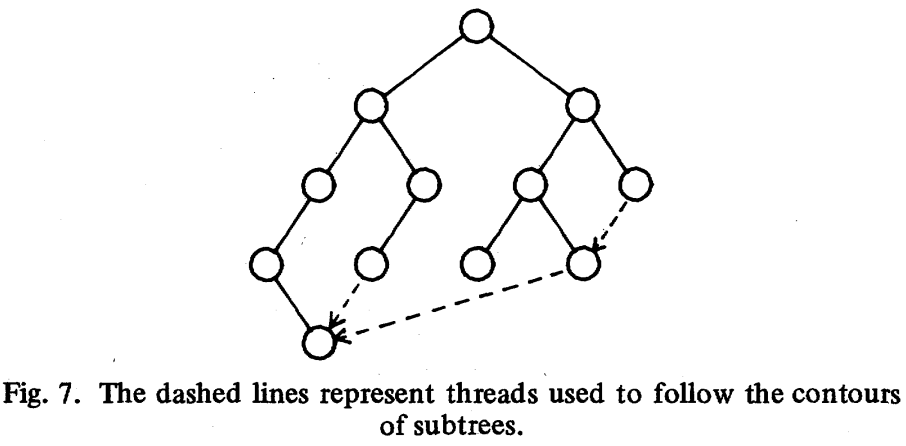
function TreeNode(node, i) {
    this.t = null; // thread
}
こうすると contour を計算するとき、実際の階層構造をまたいで thread から直接得られ、計算量は
// @see https://github.com/d3/d3-hierarchy/blob/main/src/tree.js#L15C1-L24C2
function nextLeft(v) {
    var children = v.children;
    return children ? children[0] : v.t;
}
function nextRight(v) {
    var children = v.children;
    return children ? children[children.length - 1] : v.t;
}
計算量の解析
アルゴリズムを振り返ります。まず後行順走査でノードの相対座標と thread を計算し、次に先行順走査で mod を累積して各ノードの絶対座標を決めます。この二つの走査では、各ノードが一度だけ訪問されることが明らかです。したがって、最初の走査における輪郭スキャンの計算量だけを決めればよいのです。
原論文も、この段階の計算量を数学的に解析しています。
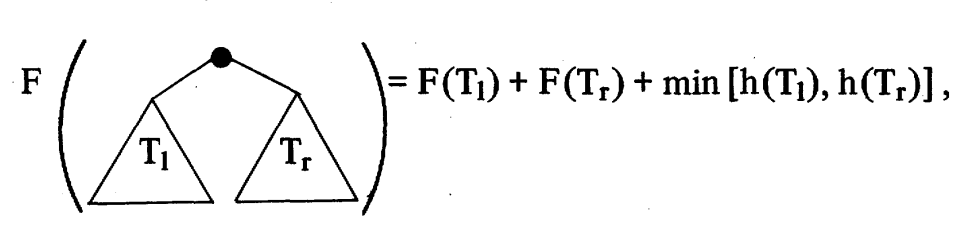
次に証明すべきなのは
著者は
帰納法を使います。
定義によれば(根ノードを加えると)次のとおりです。
代入すると次のとおりです。
したがって
N 分木への拡張
移動させる部分木を左から右へ順に処理できますが、その結果は下の図 (a) になります。右から左への走査を加えることもできますが、その場合は (b) の状況になります。目指すのは (d) の効果です。
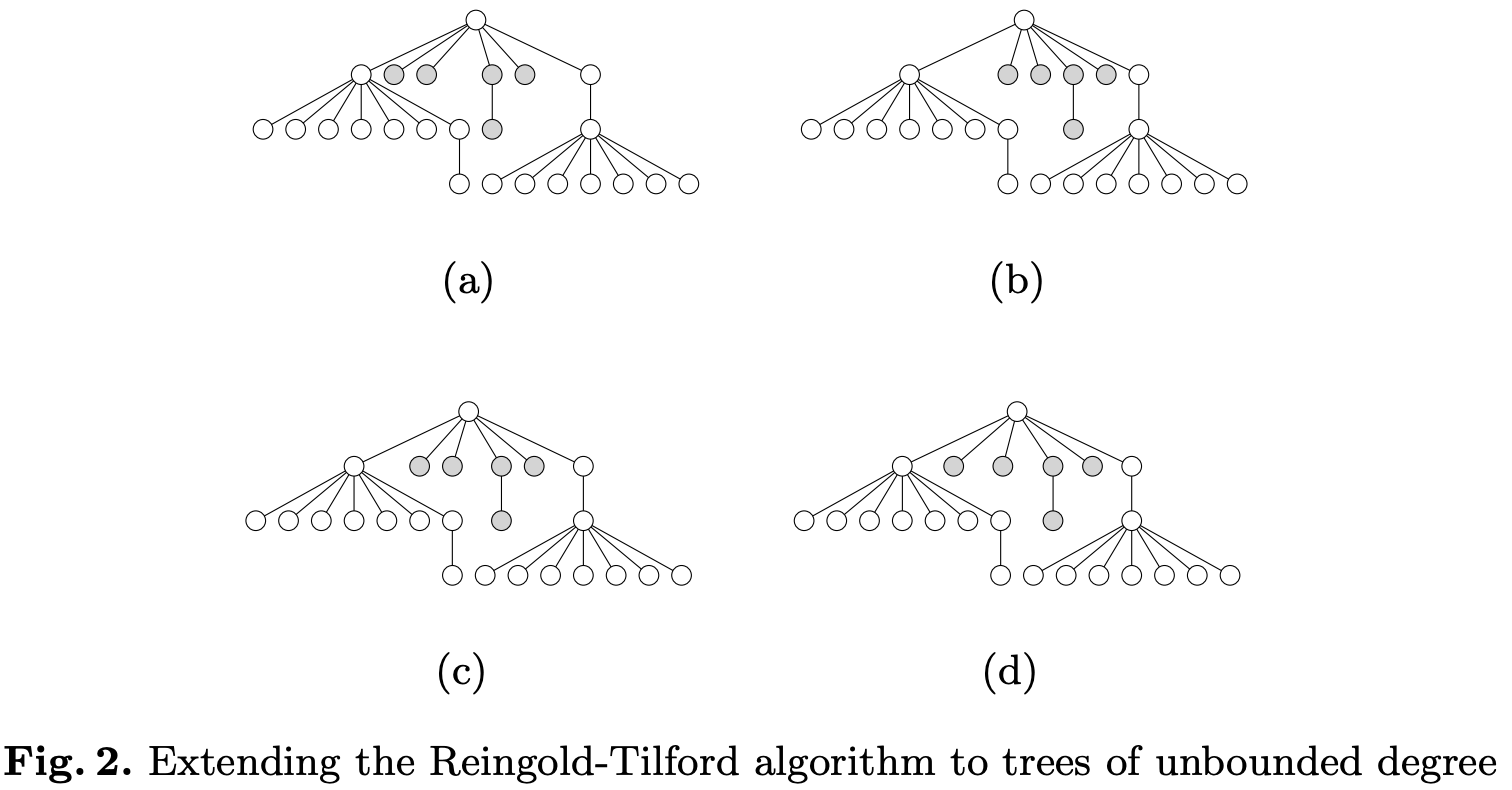
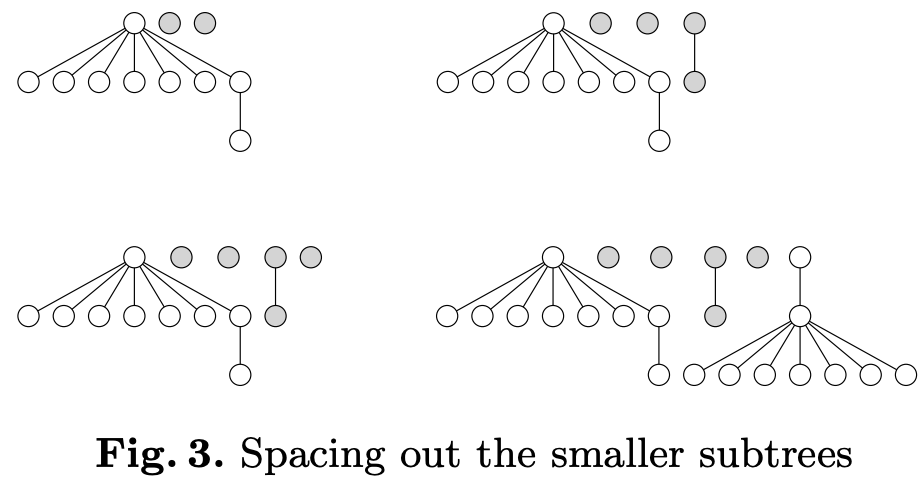
A Node-Positioning Algorithm for General Trees が解決策を提案しました。d3-tree のコード構造と変数名は、基本的にこの論文を再利用している点に注目できます。下の図は、部分木を追加していく過程での再配置の効果を示しています。
apportion 関数は、レイアウト全体の中核である「部分木間の整列ロジック」です。現在の部分木と直前の部分木の輪郭を比較し、重なっていれば現在の部分木に shift を加え、modifier を更新して子孫ノードも合わせて調整し、途中の modifier を滑らかにして「隙間」を避けます。
function apportion(v):
    leftMost = firstChild(v)
    rightMost = lastChild(v)
    defaultAncestor = leftMost

    for each child w from second to last:
        leftSibling = previousSibling(w)

        # Initialize contour pointers
        vip = w
        vim = leftSibling
        sip = vip.mod
        sim = vim.mod

        # Compare right contour of vim and left contour of vip
        while vim ≠ null and vip ≠ null:
            shift = (vim.prelim + sim + separation) - (vip.prelim + sip)

            if shift > 0:
                # Move current subtree right
                moveSubtree(ancestor(w, v, defaultAncestor), v, shift)
                sip += shift

            # move to next lower level
            vim = rightmostChild(vim)
            vip = leftmostChild(vip)

            sim += vim?.mod or 0
            sip += vip?.mod or 0

        # update default ancestor
        if rightMostChild(vim) ≠ null and leftMostChild(vip) == null:
defaultAncestor = ancestor(w, v, defaultAncestor)ノードへ属性を追加し続け、shift を保存します。
function TreeNode(node, i) {
    this.c = 0; // change
    this.s = 0; // shift
    this.A = null; // default ancestor
    this.a = this; // ancestor
}
ここで moveSubtree は、wp を根とする部分木全体を shift 単位だけ右へ動かします。
// @see https://github.com/d3/d3-hierarchy/blob/main/src/tree.js#L28C10-L28C21
function moveSubtree(wm, wp, shift) {
    var change = shift / (wp.i - wm.i);
    wp.c -= change;
    wp.s += shift;
    wm.c += change;
    wp.z += shift;
    wp.m += shift;
}
この実装の計算量は
水平方向に表示する必要があるなら、座標系を転置してノードの x/y 座標を入れ替えるだけです。
d3-flextree
上のアルゴリズムには明らかな限界があります。すべてのノードが同じ幅と高さを持つ必要があり、多くの d3-tree の例が同じ大きさの円をノードに使うのと同じです。Drawing Non-layered Tidy Trees in Linear Time と High-performance tidy trees visualization を読むことを強くおすすめします。
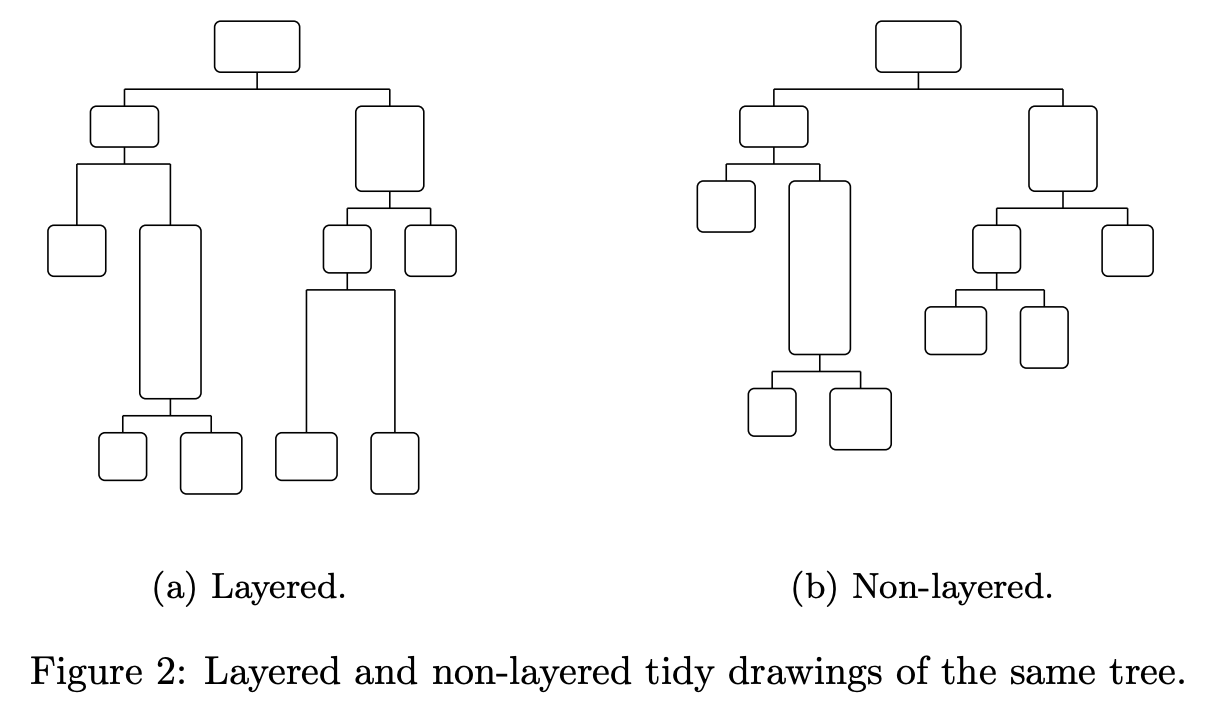
d3-flextree はこの問題を解くために作られ、markmap がそれを使っています。
そのアルゴリズムの限界は、すべてのノードが同じ大きさである木にしか適用されないことです。多くの用途には十分ですが、ノードの大きさを変えられる、より一般的な解の方が望ましいことがよくあります。
効果は次のとおりです。
@antv/hierarchy
@antv/hierarchy の mindmap アルゴリズムと mindmap-layouts は、次の美的要件を提案しています。
- ルートノードを中央に置きます
- 子ノードは左右に配置できます(通常は対称、または
getSideに従って決めます) - 同じレベルのノードは垂直方向に均等に並べます
ノードサイズの定義もサポートし、輪郭スキャンの方法は使いません。大まかな手順は次のとおりで、アルゴリズム全体の計算量は
- 1 回目のパス: 基本となる x 座標を素早く設定します。
- 2 回目のパス: 下から上へ、各部分木に必要な垂直方向の空間を計算します。
- 3 回目のパス(調整段階): 上から下へ、計算済みの空間情報を使って、すべての子ノードに重ならない y 座標を配置します。
- 4 回目のパス: 再び下から上へ、子ノードの最終レイアウトに基づいて親ノードの位置を微調整し、垂直方向の中央揃えを実現します。
効果は次のとおりです。
[WIP] インタラクション
マインドマップには特別なインタラクションが数多くあります。ノードをクリックして子ノードを展開したり折りたたんだりすることも含まれます。