23강 - 마인드맵
많은 무한 캔버스 애플리케이션이 마인드맵을 지원합니다. miro, excalidraw, canva, xmind 등이 그렇습니다. 저는 excalidraw의 분류 방식이 마음에 듭니다. 마인드맵을 세 가지 하위 유형으로 나눕니다.
- Spider mapping은 브레인스토밍에 적합하며, 중심의 핵심 주제에서 거미줄처럼 뻗어 나갑니다. 렌더링 관점에서는 mermaid도 이 유형을 제공합니다.
- Tree mapping
- Flow map
| 스파이더 매핑 | 트리 매핑 | 플로 맵 |
|---|---|---|
 |  |  |
여기서는 마지막 유형만 다룹니다.
마인드맵의 최종 표현은 크게 다를 수 있지만, 데이터 구조의 관점에서는 노드와 간선으로 이루어진 트리 구조입니다. markmap과 mermaid는 마크다운을 이 구조로 변환합니다. 트리는 특수한 그래프 구조이며, dagre나 elkjs 같은 유향 그래프용 레이아웃 알고리즘도 있지만 여기서는 다루지 않습니다.
{
    "id": "Modeling Methods",
    "children": [
        {
            "id": "Classification",
            "children": []
        }
    ]
}
이런 데이터에 대해 d3-hierarchy는 바로 쓸 수 있는 알고리즘을 여러 가지 제공하며, 우리는 d3-tree만 다룹니다.
d3-tree
먼저 두 가지 제약을 둡니다. 나중에 어떻게 깨는지 소개합니다. 대상은 이진 트리이고, 모든 노드의 크기가 같습니다(또는 크기가 없습니다).
d3-tree의 구현 아이디어는 Tidier Drawings of Trees에서 옵니다. 이 논문은 앞선 연구를 바탕으로 몇 가지 미학 기준을 제안합니다.
- 미학 기준 1: 트리의 같은 레벨에 있는 노드들은 한 직선 위에 놓여야 하며, 레벨을 정의하는 직선들은 서로 평행해야 합니다.
- 미학 기준 2: 왼쪽 자식은 부모의 왼쪽에, 오른쪽 자식은 오른쪽에 놓여야 합니다.
- 미학 기준 3: 부모는 자식들의 중앙 위에 놓여야 합니다.
- 미학 기준 4: 트리와 그 거울상은 서로의 반전인 그림을 만들어야 합니다. 또한 부분 트리는 트리의 어디에 있든 같은 방식으로 그려져야 합니다.
앞의 세 기준이 어떻게 발전하고 개선되었는지는 Drawing Presentable Trees에서 읽을 수 있습니다. 이 글은 Python 코드와 그림으로 이전 논문의 알고리즘적 사고를 자세히 보여 줍니다. 예를 들어 세 번째 기준의 구현은 단순합니다. 후위 순회를 쓰고, 부모 노드의 x 좌표를 가장 왼쪽 자식과 가장 오른쪽 자식의 중점으로 둡니다.
// @see https://github.com/d3/d3-hierarchy/blob/main/src/tree.js#L150
var midpoint = (children[0].z + children[children.length - 1].z) / 2;
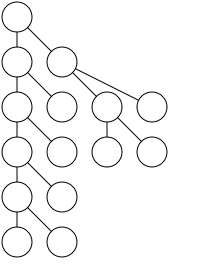
아직 충분히 대칭이 아니고 전체적으로 오른쪽으로 치우쳐 있다는 점을 분명히 볼 수 있습니다. 이것이 네 번째 기준으로 이어집니다.
| 가능한 한 좁게 | 부모는 자식들의 중앙 위에 있어야 합니다 |
|---|---|
 | 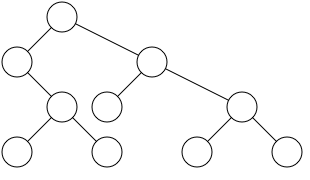 |
부모 노드를 가운데로 맞추는 연산은 형제 노드의 위치와 충돌할 수 있습니다. 이때 부분 트리 전체를 옮겨야 하는데, 다음과 같은 재귀 방식을 쓰면 알고리즘 복잡도는
def move_right(branch, n):
    branch.x += n
    for c in branch.children:
        move_right(c, n)
이때 노드에 mod 속성을 추가하면, 부모를 가운데로 맞추는 연산이 충돌을 잠시 무시하고 이동을 나중으로 미룰 수 있습니다. 이렇게 하면 재귀를 피하고 알고리즘 복잡도는 다시 prelim 속성도 새로 추가해야 하며, 이 이름은 A Node-Positioning Algorithm for General Trees에서 왔습니다.
// @see https://github.com/d3/d3-hierarchy/blob/main/src/tree.js#L67
function TreeNode(node, i) {
    this._ = node; // final position: _.x
    this.parent = null;
    this.children = null;
    this.z = 0; // prelim
    this.m = 0; // mod
}
후위 순회를 쓰기 때문입니다.
function tree(root) {
    var t = treeRoot(root);
    t.eachAfter(firstWalk);
    t.eachBefore(secondWalk);
}
두 번째 전위 순회에서 mod를 재귀적으로 누적해 오른쪽 이동을 마치고 최종 위치 _.x를 얻습니다. 이것은 원논문의 PETRIFY 단계에 해당합니다.
// @see https://github.com/d3/d3-hierarchy/blob/main/src/tree.js#L164
function secondWalk(v) {
    v._.x = v.z + v.parent.m; // final x
    v.m += v.parent.m;
}
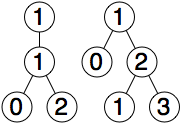
여기서 contour 개념을 소개해야 합니다. 예를 들어 아래 왼쪽 트리의 오른쪽 윤곽은 [1, 1, 2]이고, 오른쪽 트리의 왼쪽 윤곽은 [1, 0, 1]입니다. 이 두 부분 트리가 겹치지 않게 하려면 두 윤곽만 비교하면 오른쪽 트리를 오른쪽으로 얼마나 옮겨야 하는지 알 수 있습니다. 이 예에서는 이동 거리가 2입니다.
def push_right(left, right):
    wl = contour(left, lt)
    wr = contour(right, gt)
    return max(x-y for x,y in zip(wl, wr)) + 1
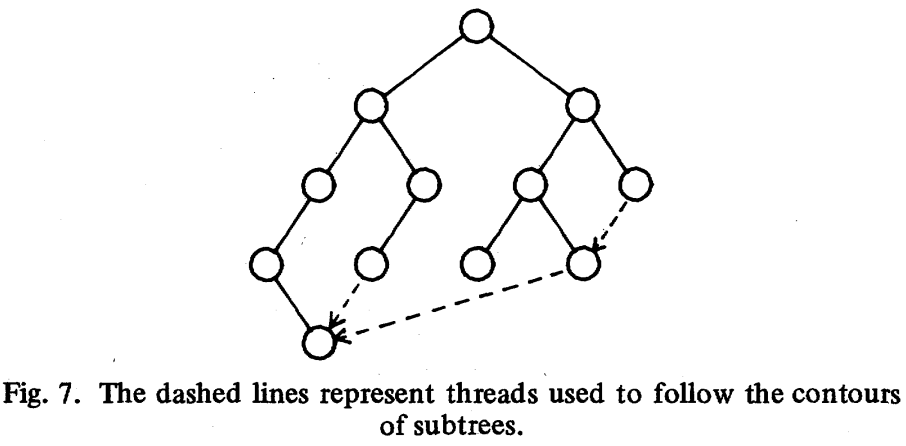
부분 트리의 윤곽을 구하는 알고리즘은 여전히 재귀가 필요하므로 복잡도는 thread 개념을 도입합니다. 아래 그림의 점선은 부모-자식과 다른 이 관계를 나타내며, 실제로 존재하지 않을 수도 있는 각 부분 트리의 윤곽을 그립니다.
function TreeNode(node, i) {
    this.t = null; // thread
}
이렇게 하면 contour를 계산할 때 실제 계층 구조를 가로질러 thread로 직접 얻을 수 있고, 복잡도는
// @see https://github.com/d3/d3-hierarchy/blob/main/src/tree.js#L15C1-L24C2
function nextLeft(v) {
    var children = v.children;
    return children ? children[0] : v.t;
}
function nextRight(v) {
    var children = v.children;
    return children ? children[children.length - 1] : v.t;
}
복잡도 분석
알고리즘을 다시 살펴보겠습니다. 먼저 후위 순회로 노드의 상대 좌표와 thread를 계산하고, 이어서 전위 순회로 mod를 누적해 각 노드의 절대 좌표를 정합니다. 이 두 순회에서 각 노드는 한 번만 방문된다는 점이 분명합니다. 따라서 첫 번째 순회에서 윤곽 스캔의 복잡도만 정하면 됩니다.
원논문도 이 단계의 복잡도를 수학적으로 분석합니다.
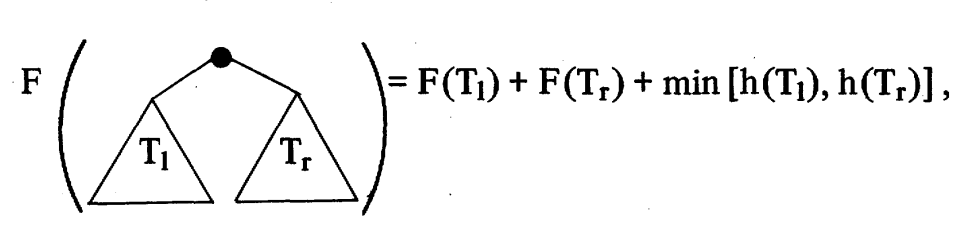
다음으로
저자는
귀납법을 사용합니다.
정의에 따르면(루트 노드를 더하면) 다음과 같습니다.
대입하면 다음과 같습니다.
따라서
N항 트리로의 확장
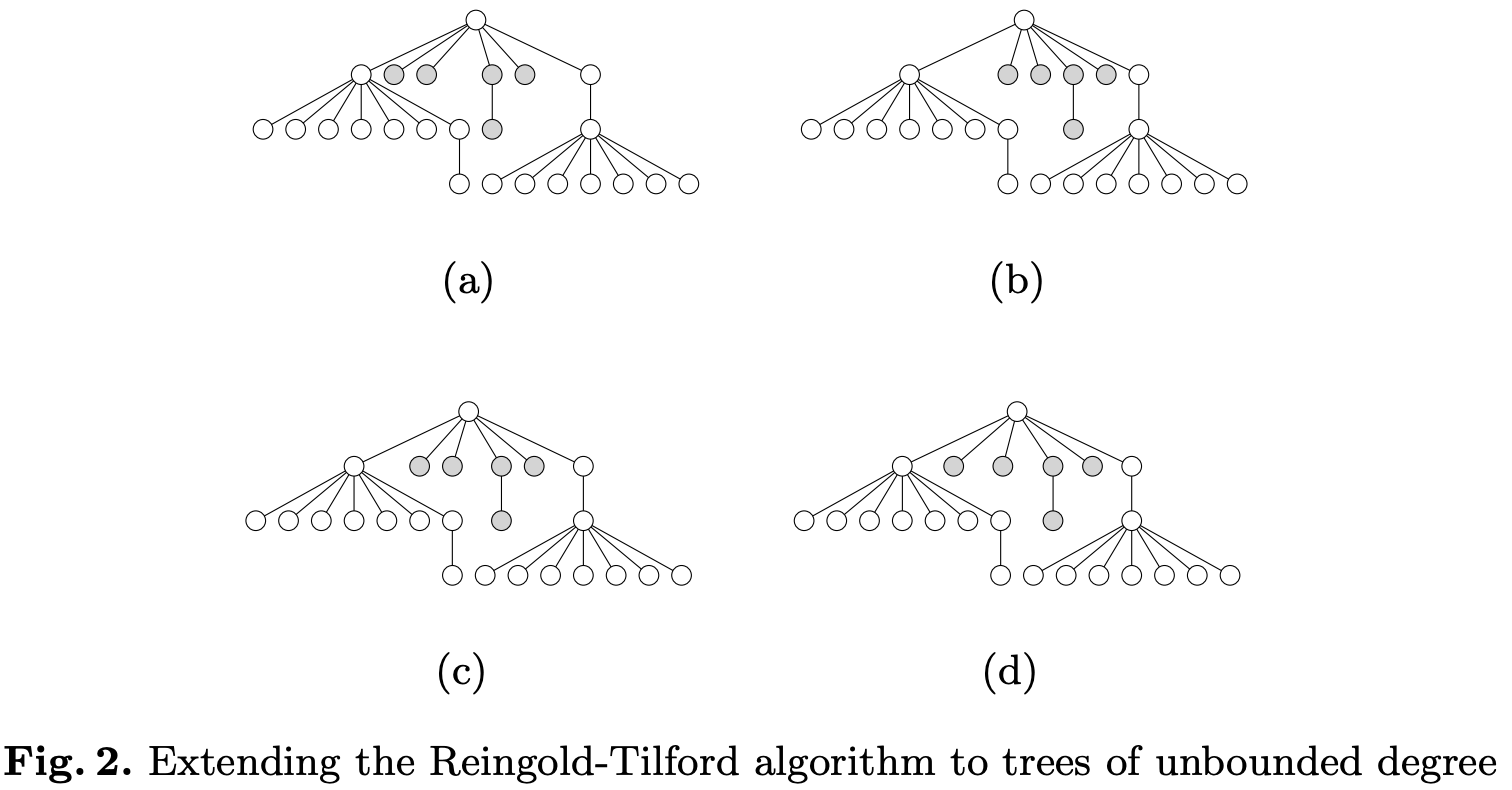
이동하는 부분 트리를 왼쪽에서 오른쪽으로 차례로 처리할 수 있지만, 그러면 아래 그림 (a)가 됩니다. 오른쪽에서 왼쪽으로의 순회를 더할 수도 있지만, 그러면 (b)의 상황이 됩니다. 원하는 것은 (d)의 효과입니다.
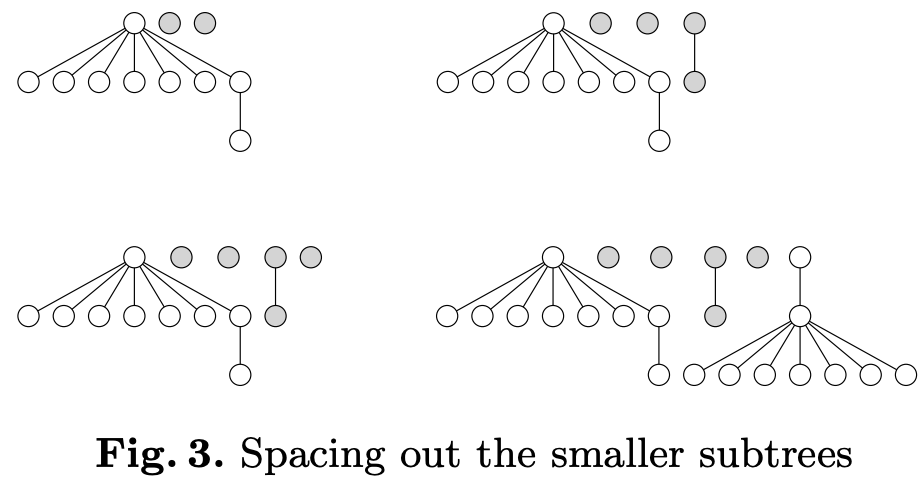
A Node-Positioning Algorithm for General Trees가 해법을 제안했습니다. d3-tree의 코드 구조와 변수 이름은 기본적으로 이 논문을 재사용한다는 점을 주목할 만합니다. 아래 그림은 부분 트리를 추가하는 동안의 재배치 효과를 보여 줍니다.
apportion 함수는 전체 레이아웃의 핵심인 “부분 트리 사이 정렬 로직”입니다. 현재 부분 트리와 이전 부분 트리의 윤곽을 비교하고, 겹치면 현재 부분 트리에 shift를 더하고, modifier를 갱신해 자손 노드도 함께 조정되게 하며, 중간의 modifier를 매끄럽게 해 “틈”이 생기지 않게 합니다.
function apportion(v):
    leftMost = firstChild(v)
    rightMost = lastChild(v)
    defaultAncestor = leftMost

    for each child w from second to last:
        leftSibling = previousSibling(w)

        # Initialize contour pointers
        vip = w
        vim = leftSibling
        sip = vip.mod
        sim = vim.mod

        # Compare right contour of vim and left contour of vip
        while vim ≠ null and vip ≠ null:
            shift = (vim.prelim + sim + separation) - (vip.prelim + sip)

            if shift > 0:
                # Move current subtree right
                moveSubtree(ancestor(w, v, defaultAncestor), v, shift)
                sip += shift

            # move to next lower level
            vim = rightmostChild(vim)
            vip = leftmostChild(vip)

            sim += vim?.mod or 0
            sip += vip?.mod or 0

        # update default ancestor
        if rightMostChild(vim) ≠ null and leftMostChild(vip) == null:
            defaultAncestor = ancestor(w, v, defaultAncestor)
노드에 속성을 계속 추가하여 shift를 저장합니다.
function TreeNode(node, i) {
    this.c = 0; // change
    this.s = 0; // shift
    this.A = null; // default ancestor
    this.a = this; // ancestor
}
여기서 moveSubtree는 wp를 루트로 하는 부분 트리 전체를 shift 단위만큼 오른쪽으로 옮깁니다.
// @see https://github.com/d3/d3-hierarchy/blob/main/src/tree.js#L28C10-L28C21
function moveSubtree(wm, wp, shift) {
    var change = shift / (wp.i - wm.i);
    wp.c -= change;
    wp.s += shift;
    wm.c += change;
    wp.z += shift;
    wp.m += shift;
}
이 구현의 복잡도는
가로로 표시해야 한다면, 좌표계를 전치하여 노드의 x/y 좌표를 바꾸면 됩니다.
d3-flextree
위 알고리즘에는 분명한 한계가 있습니다. 모든 노드의 너비와 높이가 같아야 하며, 많은 d3-tree 예제가 같은 크기의 원을 노드로 쓰는 것과 같습니다. Drawing Non-layered Tidy Trees in Linear Time과 High-performance tidy trees visualization을 읽어 보시기를 권합니다.
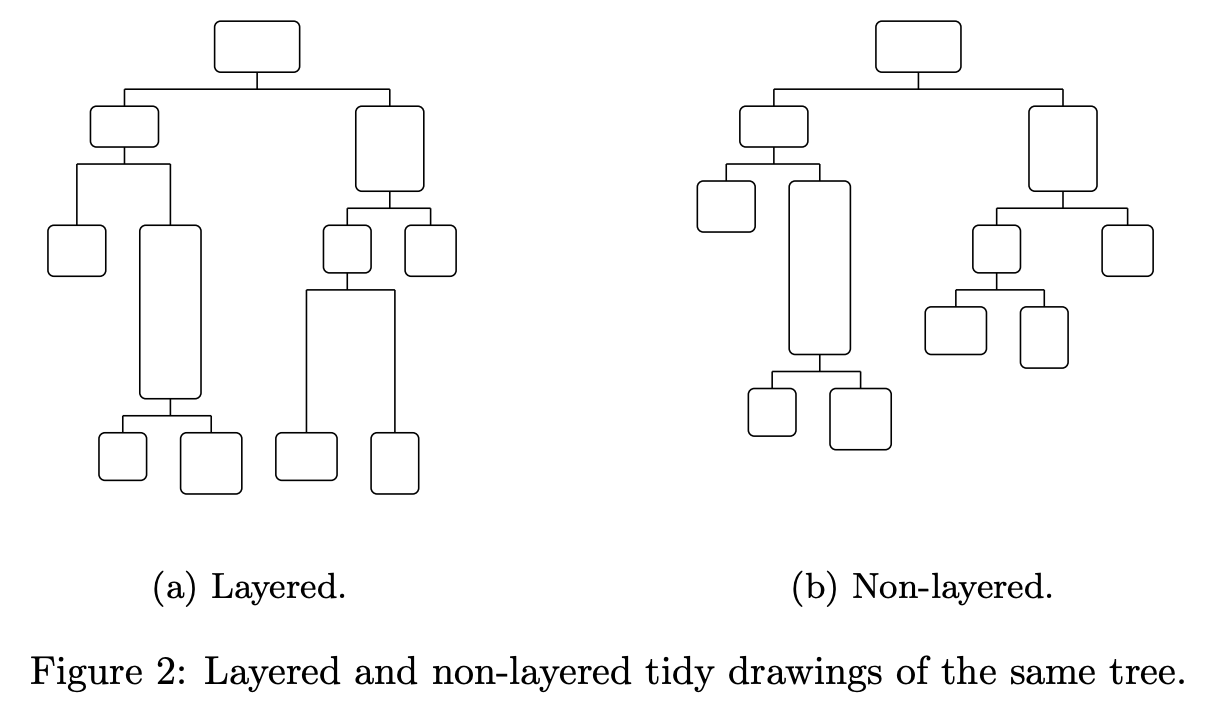
d3-flextree는 이 문제를 풀기 위해 만들어졌고, markmap이 이것을 사용합니다.
그 알고리즘의 한계는, 모든 노드의 크기가 같은 트리에만 적용된다는 점입니다. 많은 응용에는 충분하지만, 노드 크기가 달라도 되는 더 일반적인 해법이 바람직한 경우가 많습니다.
효과는 다음과 같습니다.
@antv/hierarchy
@antv/hierarchy의 mindmap 알고리즘과 mindmap-layouts는 다음 미학 요구를 제안합니다.
- 루트 노드를 가운데에 둡니다
- 자식 노드는 왼쪽과 오른쪽으로 배치할 수 있습니다(보통 대칭이거나,
getSide에 따라 정합니다) - 같은 레벨의 노드는 세로로 고르게 배열합니다
노드 크기를 정의하는 것도 지원하며, 윤곽 스캔 방식은 쓰지 않습니다. 대략적인 단계는 다음과 같고, 알고리즘 전체의 복잡도는
- 첫 번째 패스: 기본 x 좌표를 빠르게 설정합니다.
- 두 번째 패스: 아래쪽에서 위쪽으로, 각 부분 트리에 필요한 세로 공간을 계산합니다.
- 세 번째 패스(조정 단계): 위쪽에서 아래쪽으로, 계산된 공간 정보를 써서 모든 자식 노드에 겹치지 않는 y 좌표를 배치합니다.
- 네 번째 패스: 다시 아래쪽에서 위쪽으로, 자식 노드의 최종 레이아웃에 따라 부모 노드의 위치를 미세 조정하여 세로 가운데 맞춤을 이룹니다.
효과는 다음과 같습니다.
[WIP] 상호작용
마인드맵에는 특별한 상호작용이 많습니다. 노드를 클릭해 자식 노드를 펼치거나 접는 것도 포함됩니다.